短剧出海多语言 AI 译制:从 0 到 1 落地,算力与分发带宽要多大配置才够
场景复盘:6 人团队,一周要出 80 集多语字幕与配音
一个典型的中小短剧出海团队,内容侧 3 人、技术侧 2 人、投流 1 人。业务链路是:国内采购或自制短剧素材 → 多语言译制(字幕、配音、口型对齐)→ 批量出片 → 投流测试(TikTok、Meta、独立站落地页)→ 数据回传决定下一批素材方向。最初的瓶颈不在内容,而在「出片速度」:单条 2 分钟短剧,做 5 个语种的字幕 + 配音 + 简单唇形处理,在本地一台带消费级显卡的工作站上要跑 40 分钟以上,一周的产能只够 20 集,投流素材根本跟不上。
这个阶段最容易犯的错,是把「AI 译制」当成一个纯软件问题,先买一堆 SaaS 额度,结果发现批量任务排队、语种越多越慢、素材上传下载还卡在跨境网络上。真正要算的是三笔账:推理算力、存储与转码、分发带宽。
算力怎么估:显存、并发与批量任务队列
多语言译制一般拆成几个模型环节:语音识别(ASR)、机器翻译、语音合成(TTS)、可选的唇形驱动或数字人口型。中小团队通常不会自研,而是用开源模型(如 Whisper 系、Qwen 系翻译模型、CosyVoice 类 TTS)做私有化部署,或用 Ollama、vLLM 这类推理框架把模型跑在自己的机器上,避免按次计费把成本推高。
显存估算的通用经验:7B 级翻译模型做 INT8 或 FP16 推理,单卡 24G 显存基本够跑 2~4 路并发;ASR 与 TTS 模型显存占用更低,但批量任务多时更吃显存碎片和调度。如果只是字幕翻译 + TTS 配音,不碰唇形驱动,一张 24G 卡(如 RTX 4090 级别)就能撑起一天几十集的产能;一旦要做口型对齐或数字人出镜,显存和算力需求会明显上一个台阶,通常建议 48G 以上,或直接拆成多机流水线。
实操上更稳的做法是「CPU 机器做调度与转码,GPU 机器只做推理」。转码、切片、字幕烧录这些活对 GPU 没意义,却会抢 CPU 和磁盘 IO。把任务队列(如用 Redis + 简单 worker)放在前置机器上,GPU 机器只接推理请求,出片失败时也更容易定位是哪一环出的问题。
分发带宽怎么配:投流素材的「上传—回传」才是隐形瓶颈
短剧出海的分发不是传统意义上的「给观众推流」,而是给投流平台批量上传素材、给独立站分发视频、以及团队跨境协作时的文件回传。一条 2 分钟 1080P 成片大约 150~300MB,一周 80 集 × 5 语种就是几百个文件,如果每次都要从国内上传到海外广告后台,跨境链路的抖动会直接拖慢投流节奏。
通用判断标准:素材上传与回传占主导的团队,优先看上行带宽和到目标市场的线路质量;面向观众播放的独立站,才需要重点看下行带宽与 CDN 回源。100M 带宽的海外机器,足以支撑每天几十 GB 级别的素材中转与站点分发;如果要做 10G 级别的大带宽不限流量机型,更多是给「多语种成片库 + 批量下载 + 多地团队同步」这种场景准备的。地区选择上,东南亚与日韩市场优先考虑新加坡、日本机房,欧美投流为主则看美国西海岸与德国节点,线路方面 CN2、BGP 国际带宽的实际体验差异,往往比纸面带宽数字更影响上传速度。
从 0 到 1 的落地步骤与踩坑清单
- 先跑通单条链路:拿一条 2 分钟样片,把 ASR → 翻译 → TTS → 烧字幕跑通,记录每环节耗时,再乘语种数估算周产能。
- 再定机器规格:推理机按显存定,调度与转码机按 CPU 核数和 SSD 容量定,素材库单独挂大盘或对象存储。
- 最后配分发:按目标市场选机房地区,先小带宽验证上传速度,再决定是否升到 G 口或 10G。
常见坑:一是只买 GPU 不管存储,成片和中间文件很快把系统盘塞满;二是用国内机器做海外投流中转,上传慢且不稳定;三是忽略多语种字幕的字体与编码,阿拉伯语、泰语等语种烧录后出现乱码或断行;四是把合规当小事,涉及用户数据与配音版权时,优先选政策相对清晰、跨境链路成熟的地区机房。价格量级上,海外大带宽物理机一般从每月一两百元到一两千元不等,GPU 云按小时计费看似灵活,但批量出片跑满一个月,物理机往往更可控。
选购推荐
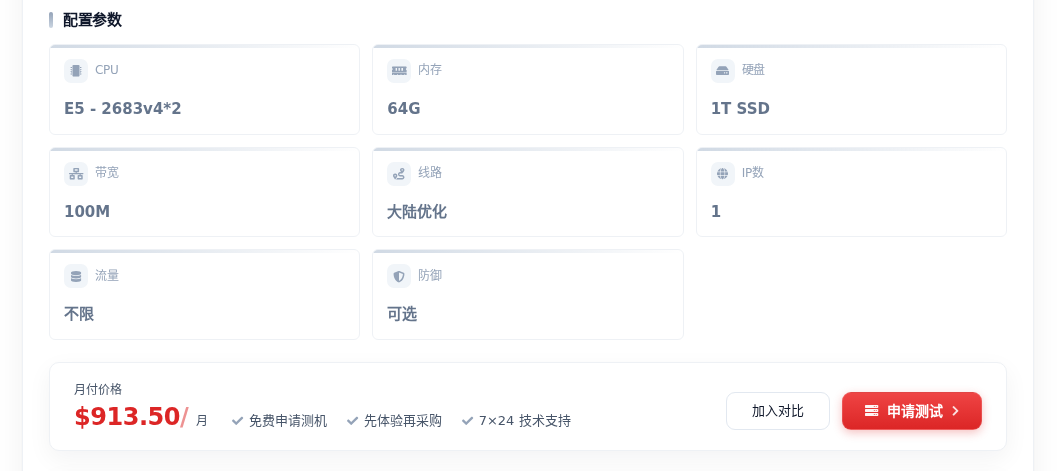
结合上面的链路,推荐两款适合短剧出海团队的机型。做素材中转、批量出片调度与独立站分发的,可以看新加坡大带宽服务器 IX,E5-2683v4*2 / 64G / 1T SSD / 100M 带宽,913.5 元/月,东南亚与日韩投流的上传回传体验比较均衡,64G 内存也够同时跑转码队列和轻量推理调度。如果团队以欧美市场为主、需要更大带宽做多语种成片库同步,美国洛杉矶大带宽服务器 XIX 更合适,E5-2683v4*2 / 64G / 1T SSD / G 口带宽,628.5 元/月,G 口带宽对批量上传投流素材和独立站分发都更从容。
决策建议:先用一台中等配置的海外大带宽机器把「译制—出片—上传」链路跑顺,确认周产能瓶颈在算力还是带宽,再决定是否单独加 GPU 推理机;不要一开始就堆 10G 带宽,先把线路和地区选对,比盲目加配置更省钱。