短剧批量译制出片:显存和带宽配错的三个坑,怎样一次配够
案例背景:三个人、一百集短剧、六种语言
一个三人小团队手里有约一百集竖屏短剧,单集 2~3 分钟,计划做英语、西语、葡语、印尼语、泰语、阿语六个语种的字幕与配音版本,再投到 TikTok、YouTube Shorts 和独立站。初期为了省钱,把译制推理放在一台 24G 显存的云 GPU 上,把成片放回原来做官网的那台 4G 内存、百兆带宽的小机器上分发。
结果很快暴露:字幕翻译与配音对齐排队严重,一集要跑十几分钟;成片一多磁盘就满;投放素材的下载链接在东南亚打开极慢,运营反复催。复盘下来,问题不在模型,而在显存估算、存储吞吐、分发带宽三件事没有一次配够。
坑一:显存按模型参数量买,忽略了译制链路的峰值
短剧译制不是单模型任务,一般包含语音识别、字幕翻译、配音合成、口型或时长对齐、字幕烧录几个环节。很多人只按翻译模型的参数量估显存,实际峰值往往出现在语音识别和批量并发上。
- 估算方法:7B 级模型做 FP16 推理通常需要 16G 以上显存,量化到 INT8/INT4 可压到 8~12G;再叠加语音识别、TTS 与批处理缓存,单卡 24G 是比较稳妥的起步线,48G 以上才能比较舒服地跑多路并发。
- 并发不要贪:24G 卡上同时跑两三个译制任务就会明显降速,排队策略比堆并发更有效。
- 避坑:优先选显存大而不是核心多的卡;推理阶段显存是硬门槛,算力过剩显存不够等于白买。
这个环节的常见量级:云 GPU 按小时计费,24G 卡每月全时运行通常在数千元级,48G 级更高;如果译制是持续业务而非偶发任务,物理机或长租方案的单位成本一般更低,具体视服务商而定。
坑二:成片存储和出片吞吐没算进去
一集竖屏短剧成片按 200~400MB 算,六个语种就是 1.2~2.4G,一百集接近 150~250G,加上中间素材、字幕工程文件和历史版本,很容易到 500G 以上。用系统盘硬扛,磁盘一满,出片和上传都会卡。
- 译制机建议系统盘与数据盘分离,数据盘至少 1T,优先 NVMe 或 SSD,批量转码与切片对随机读写敏感。
- 成片归档与分发分开:归档放普通 HDD 大盘,分发只放近期投放的素材。
- 判断标准:如果每天新增成片超过 20G,就不要考虑小容量云盘,直接上大硬盘物理机。
坑三:分发带宽按官网标准买,投放素材直接卡死
短剧出海的分发有两个特点:峰值集中(投流起量时几十个素材同时被拉取)和地域分散(东南亚、拉美、中东同时在线)。百兆带宽在投放起量时基本不够用。
- 带宽估算:按单个素材 50~300MB、同时在线下载几十路来估,G 口带宽是投放期的合理起点;小规模试水可用 250M~500M 过渡。
- 地区选择:面向东南亚,新加坡、马来西亚节点延迟更低;面向日韩,日本节点更合适;面向港台与大陆运营团队协同,香港节点线路更稳;面向欧美投放,美国节点更直接。不要一个节点打全球。
- 避坑:注意「带宽」与「流量」是两回事,标 G 口但月流量只有 100T 的机型,投放量一大就会触发限速或加购。
选购推荐
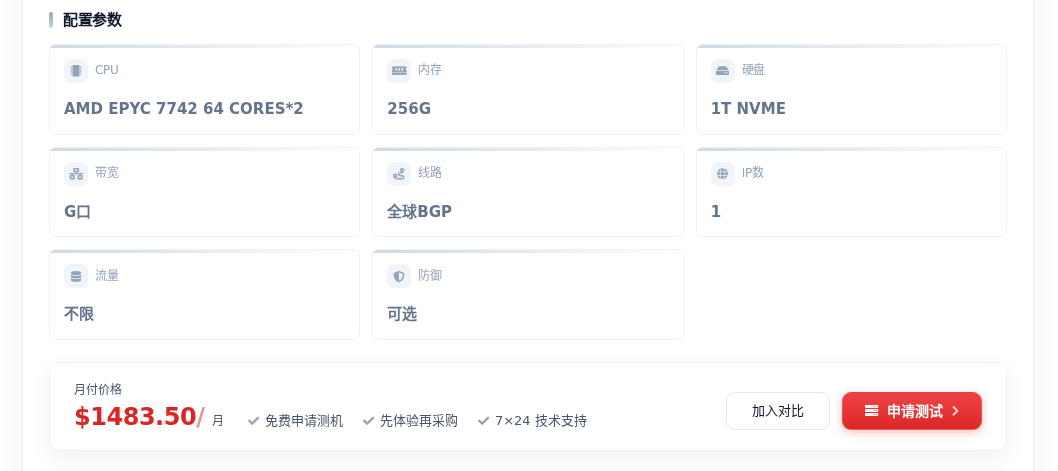
结合上面的三个坑,这类团队真正需要的是大显存推理机 + 大带宽分发机分开配置。分发侧如果以东南亚和日韩投放为主,日本大带宽服务器 XL 比较对口:AMD EPYC 7742 双路、256G 内存、1T NVMe、G 口带宽,1483.5 元/月,内存和 NVMe 足够承担成片切片、字幕烧录和素材库分发,G 口带宽能扛住投流起量的并发拉取。
如果预算更紧、先跑小规模试水,日本大带宽服务器 IV 是更轻的选择:E5-2630L、16G 内存、1T HDD、G 口带宽、500T 流量,223.5 元/月,适合做素材中转与归档分发,等投放量稳定后再升级。注意它的内存和 HDD 不适合跑推理,只做分发与存储。
决策建议
短剧批量译制出片的配置顺序应该是:先按译制链路峰值定显存(24G 起步、48G 更从容),再按每日新增成片定存储(1T 起、SSD 优先),最后按投放地域和并发定带宽(G 口起步、按目标市场选节点)。三件事分开算、分开买,比在一台机器上硬凑更省钱,也更不容易在起量那天掉链子。