短剧批量AI译制出片,算力与分发带宽如何按节奏配机器才不踩坑
短剧出海的做法正在变:过去是人工翻译字幕、逐条剪辑、按周出片;现在不少团队用大模型做多语种译制,配音、字幕、口型对齐、封面文案批量生成,一天能出几十条甚至上百条多语言版本。变化带来的直接后果是——机器配置不再按“一个网站一台机”来算,而是按“译制流水线 + 分发 + 站群承载”三条并行的节奏来配。配错了,要么出片卡在渲染队列,要么视频发出去海外用户打不开,要么硬盘先爆。
坑点一:把译制算力当成一次性采购,出片节奏一上来就断
AI 译制不是单次任务,而是持续流水线:语音识别转写、机器翻译、TTS 配音、字幕合成、封面与标题批量生成,每一环都吃资源。常见的错误是先用一台低配机器试水,跑通后直接放大批量,结果 GPU 显存不够、CPU 渲染排队。
判断标准与配置量级:
- 纯字幕翻译与文案生成:CPU 为主即可,8 核以上、32G 内存能撑起中小批量;
- 带 TTS 配音与音视频合成:建议独立 GPU,显存 16G 起步,24G 更稳,模型量化后可显著降低显存占用;
- 批量出片阶段:瓶颈往往在转码与磁盘 IO,NVMe 比 HDD 快一个量级,素材库和成片库建议分开存放;
- 如果只是跑开源模型做翻译和文案,物理机长期占用通常比按小时计费的云 GPU 更划算;短时峰值再考虑弹性算力补位。
避坑要点:不要用“能跑通一条”来推断“能跑通一天”。按日均出片条数倒推:每条视频从转写到成片,视配音与合成复杂度,单条占用机器时间通常在几分钟到十几分钟量级,先按这个量级估算并发,再决定是单机多任务还是多机拆分。
坑点二:分发带宽按“够用”买,投流一放量就限速
短剧的流量结构很集中:投流素材、落地页、成片播放,三者都吃带宽。矩阵站群从业者的真实场景是——同一批成片要铺到多个站点、多个语种落地页,还要给投流平台回传素材。带宽买小了,页面首屏慢,转化直接掉。
判断标准与配置量级:
- 成片播放尽量交给对象存储或 CDN,源站只做回源,不要把大文件播放压在站群服务器上;
- 源站带宽按“日均出片体积 × 回源比例”估算,100M 带宽适合中小规模站群与素材中转,300M 以上更适合批量出片与多站同步;
- 地区选择看目标市场:东南亚与港台用户优先香港、新加坡节点,延迟低;欧美投放为主则美国西海岸机房更合适;日本节点对日本与部分东亚市场更友好;
- 线路方面,面向中国大陆团队做管理后台时,CN2 或优化线路体验更好,纯国际带宽价格低但高峰波动明显。
避坑要点:G 口带宽不等于 G 口可用,注意是否限流量、是否共享、超量后的计费方式。批量出片阶段最容易踩的坑是“带宽够但磁盘写满”,成片和素材一定要做冷热分层。
坑点三:站群与译制混在一台机器,互相拖累
矩阵站群的特点是站点多、进程多、IP 需求多;AI 译制的特点是短时高负载。两者混跑,译制一开满,站点响应就抖。更合理的做法是分层:译制与渲染用高配机器,站群承载用多 IP 的中低配机器,素材分发走带宽型机器。
操作步骤建议:
- 先定出片节奏:日均条数、语种数、是否需要配音,决定算力档位;
- 再定分发结构:源站、CDN、对象存储各承担什么,决定带宽与硬盘;
- 最后定站群规模:站点数量与 IP 需求,决定站群机器的数量与地区分布;
- 留出 30% 左右的资源余量,投流放量往往没有预告。
选购推荐
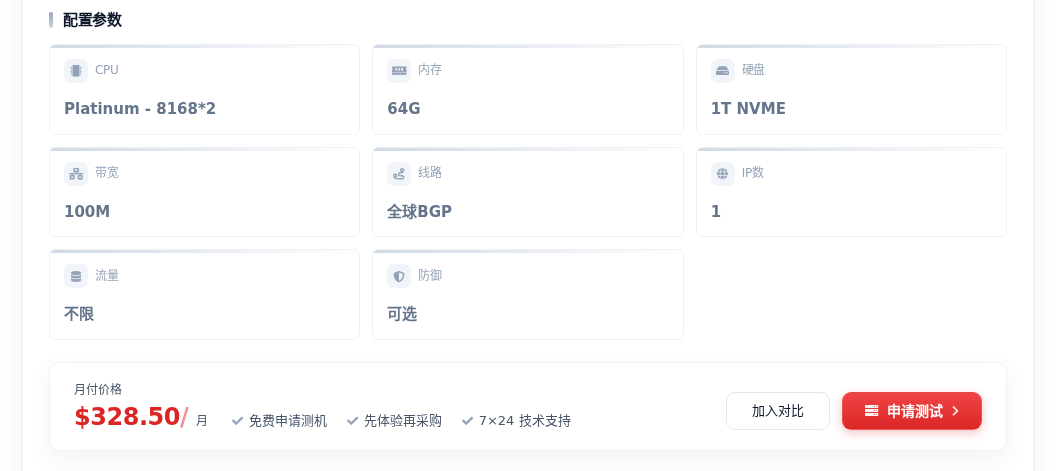
按上面的节奏,起步阶段可以用一台带宽型机器承接站群与素材中转,译制任务放独立机器。香港节点适合面向东南亚与港台的站群分发,香港大带宽服务器 XIV(Platinum-8168*2 / 64G / 1T NVME / 100M 带宽,328.5 元/月)配置偏均衡,NVMe 对批量读写友好,适合中小矩阵站群与素材库。
如果译制与出片量已经上来,且投放主战场在日本及东亚市场,日本大带宽服务器 XXVIII(Platinum-8168*2 / 64G / 1T NVME / 300M 带宽,748.5 元/月)的 300M 带宽更适合成片回源与多站同步,双路 Platinum 也能扛住转码与合成时的并发压力。欧美投放为主的团队,可再按需补充美国西海岸节点做分发。
决策建议:先用一台带宽型机器跑通站群与分发,再按日均出片量单独配译制机器;带宽按目标市场选地区,硬盘按成片体积留余量,GPU 按是否配音决定要不要上。别在第一步就把预算压在算力上,分发带宽和存储往往是更早暴露的瓶颈。