短剧批量AI译制出片,模型下载与分发带宽要多大配置才够?
短剧出海团队真正卡住的地方,往往不是翻译质量,而是「片源进来、成片出去」这一段链路:一部 80 集短剧要批量出英、西、葡、日多语版本,模型权重动辄几十 GB,成片一天几十条往外推,还要同步给投流和分发。链路里有两处带宽开销最容易被低估——模型下载与镜像同步、成片分发与回源。下面按运维和开发者能直接照着算的方式展开。
先算清三笔账:显存、存储、带宽
显存与算力
批量译制通常分三步:ASR 转写、LLM 翻译与润色、TTS 配音与口型对齐。翻译环节用 7B~14B 量化模型在单卡 24G 显存上即可跑起来,并发靠批处理提升;若要做字幕润色、多语改写、审校一体,14B~32B 更稳,需要 48G 以上显存或多卡。语音克隆与 TTS 对显存要求不高,但批量时吃 CPU 与并发。判断标准很简单:单条 2 分钟片段,从转写到成片,若耗时超过 3~5 分钟,就要考虑加卡或拆分任务队列,而不是继续堆并发。
存储
短剧素材是典型的「大文件 + 高频读写」:原始素材、中间音频、字幕、多语成片、封面与切片。一个中等规模团队,在制项目加历史归档,通常需要数 TB 起步。选机器时优先看是否带 NVMe 或 SSD 做工作盘,HDD 只适合做归档;素材盘与模型盘分开,避免模型读写把出片 IO 拖死。
带宽
模型下载是一次性成本,但要算峰值:一个 14B 量化权重加配套组件,单次拉取常见在 10~30GB 量级,多机部署时就是乘以节点数。成片分发才是持续成本:一天出 50 条、平均 100MB 的成片,日流量约 5GB,看似不大,但投流素材要反复回源、给代理商和分发方拉取,加上切片与封面,实际出网往往是估算的 3~5 倍。按「日均出片量 × 单条体积 × 3~5 倍冗余」估带宽,比拍脑袋选 G 口更靠谱。
按需求选机器:三类角色的配置清单
- 译制主节点(GPU):负责转写、翻译、配音。关注显存、卡数、是否支持独享而非共享;模型盘用 SSD;对带宽要求中等,百兆级够用,重点是稳定出网。
- 素材与出片中转(大带宽 CPU 机):跑队列、切片、转码、上传分发。这是带宽消耗主力,优先看带宽是否独享、流量是否有限制、回源是否额外计费。G 口带宽机型在这个角色上性价比最高。
- 分发与投流前置:面向东南亚、日韩、欧美的分发节点,关注到目标市场的线路质量与延迟,而不是单纯堆带宽。
对比参数时至少拉一张表:带宽是否独享、月流量上限与超量计费、硬盘类型与 IO、是否可加 IP、到目标地区的延迟与丢包、是否含基础高防。很多低价方案标称 G 口,实为共享峰值,晚高峰出片上传会明显掉速,这是短剧团队最常见的坑。
地区怎么选:把模型下载和分发分开看
模型下载与镜像同步,优先放在国际出口好、到主流模型源站拉取稳定的地区,香港、新加坡、日本通常更顺;成片分发则跟着观众走,东南亚观众多就考虑新加坡、马来西亚节点,日韩市场看日本节点,欧美投流看美国西海岸。合规上,涉及用户数据与配音素材的处理,尽量让译制与存储留在同一司法辖区,减少跨境传输解释成本。实操建议:主译制节点放一处,分发与中转按市场分散,用对象存储或 CDN 兜住回源,不要把全部流量压在一台机器上。
选购推荐
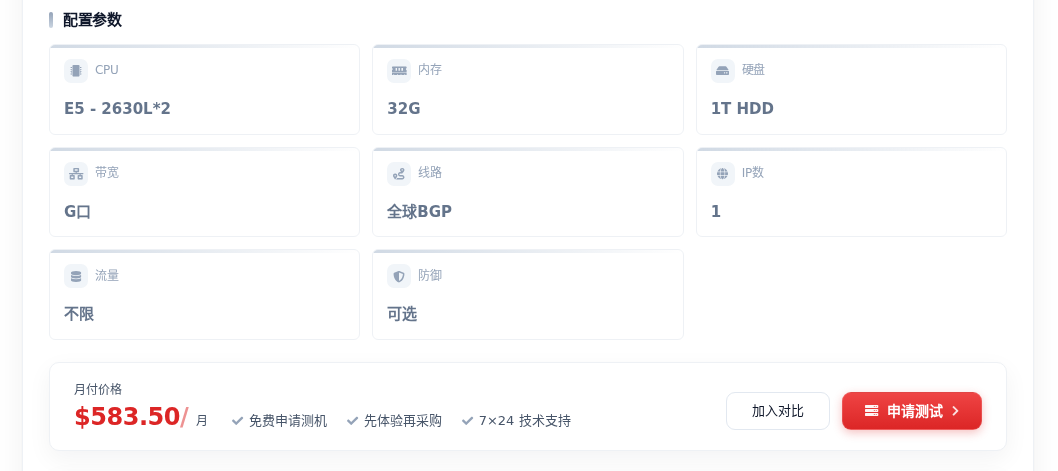
按上面的账来对,两类机型最贴合短剧译制团队。做素材中转、切片转码与批量上传的,可以看香港大带宽服务器 XXII:E5-2630L*2 / 32G / 1T HDD / G 口带宽,583.5 元/月,双路 CPU 适合跑转码队列,香港到内地与东南亚的线路都比较顺,适合当出片与分发的中转主力;预算更紧、以东南亚分发为主的,可以看日本大带宽服务器 IX:E5-2630L / 16G / 1T HDD / G 口带宽、100T 流量,283.5 元/月,拉取模型和往日本、东南亚推成片都够用,适合作为起步阶段的分发节点。GPU 译制节点建议单独按显存需求选,不要和分发机混在一台上。
决策建议
先把日均出片量、单条成片体积、目标市场三个数写下来,反推带宽与流量,再决定机器数量;模型下载与成片分发分开部署,别用一台机器扛全链路。起步阶段用一台大带宽 CPU 机做中转加分发,配一台按显存选的 GPU 机跑译制,跑顺了再按市场加节点。签约前务必确认带宽独享、流量上限与超量计费,这三项比价格更影响后期成本。